


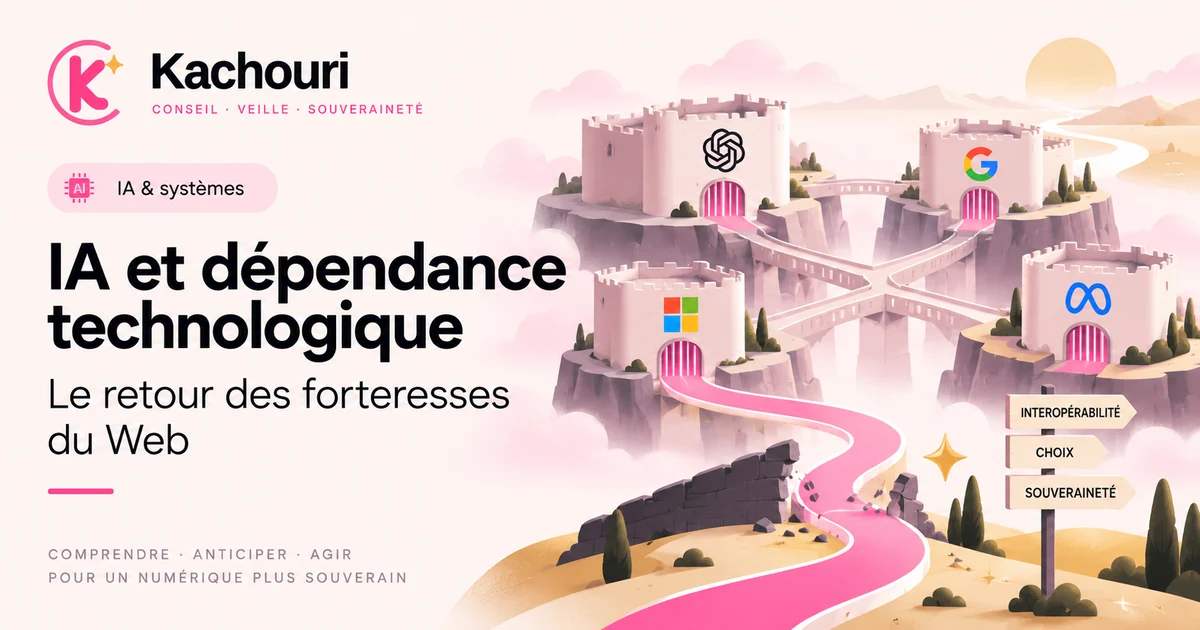
L’IA générative ne crée pas seulement de nouveaux usages. Elle recompose aussi les dépendances technologiques des organisations : modèles, agents, API, mémoire, identités et plateformes d’orchestration deviennent autant de points de verrouillage possibles. Derrière la course au "meilleur modèle", l’enjeu durable pourrait être l’interopérabilité, la réversibilité et la maîtrise de la connaissance.
IA générative : l’abondance recrée de la fragmentation
OpenAI, Anthropic, Google, xAI, DeepSeek, Kimi et de nombreux autres acteurs proposent aujourd’hui des modèles capables d’écrire, de coder, de rechercher, d’analyser, de raisonner ou de piloter des outils. Autour d’eux s’est développé tout un écosystème d’assistants spécialisés, d’agents, de wrappers, d’automatisations, de connecteurs et de plateformes d’orchestration. À première vue, cette abondance ressemble à une forme d’émancipation technologique : jamais les organisations n’ont eu accès à autant de capacités, aussi rapidement et avec un coût d’entrée aussi faible.
La réalité est plus ambiguë. À mesure que les possibilités augmentent, les architectures se fragmentent. Chaque équipe, chaque service, parfois chaque individu, finit par construire sa propre pile : un modèle pour rédiger, un autre pour coder, une API spécialisée pour enrichir les données, un connecteur MCP pour accéder à un outil interne, une base de connaissances, un moteur de recherche supplémentaire, puis quelques automatisations destinées à relier l’ensemble. Le système fonctionne jusqu’au moment où un fournisseur modifie une API, qu’un autre change ses conditions, qu’un modèle jusque-là secondaire devient meilleur sur une tâche précise ou qu’une fonction payante se retrouve intégrée ailleurs. Il faut alors arbitrer, migrer, adapter, tester de nouveau.
Le paradoxe apparaît progressivement : nous voulions automatiser le travail, mais nous passons une part croissante de notre temps à administrer les couches d’automatisation elles-mêmes. Cela ne signifie pas que l’IA a échoué, ni même que cette complexité soit anormale. Elle traduit aussi la jeunesse d’un marché encore instable, où les positions, les interfaces et les usages évoluent presque en temps réel. Elle révèle cependant un risque déjà connu dans l’histoire du numérique : confondre sophistication technique et création de valeur, puis transformer la recherche d’autonomie en accumulation de dépendances.
Interopérabilité du Web : une mécanique ancienne sous des technologies nouvelles
Chaque grande vague technologique aime se raconter comme une rupture avec la précédente. Pourtant, lorsque l’on regarde les infrastructures plutôt que les interfaces, les mêmes mouvements de balancier reviennent avec une régularité troublante.
Le premier Web s’est construit autour d’une idée fondamentale : des systèmes différents devaient pouvoir communiquer sans qu’une plateforme centrale autorise chaque échange. HTTP, URI et HTML ont fourni ce langage commun. Le 30 avril 1993, le CERN a placé le logiciel du World Wide Web dans le domaine public, avant de le diffuser sous licence ouverte. Ce geste n’explique évidemment pas à lui seul l’essor du Web, mais il a contribué à créer un environnement dans lequel chacun pouvait publier, relier et expérimenter sans demander la permission à un intermédiaire dominant.
Ce Web était imparfait, lent, parfois austère et techniquement beaucoup moins accessible que celui que nous connaissons aujourd’hui. Il possédait néanmoins une qualité essentielle : l’interopérabilité n’était pas une option ajoutée après coup, elle faisait partie de son architecture.
Le Web 2.0 a ensuite apporté une expérience infiniment plus fluide. Les réseaux sociaux, les plateformes vidéo, les moteurs de recherche modernes, les clouds et les grandes applications ont supprimé une grande partie des frictions. Cette simplification a produit une valeur considérable, mais elle s’est accompagnée d’un déplacement du pouvoir. La page personnelle est devenue le profil, le forum est devenu le groupe, le flux ouvert est devenu le fil algorithmique et l’hébergement est devenu une infrastructure cloud administrée par quelques géants. Dans de nombreux cas, la relation directe entre deux acteurs a laissé place à une relation médiée par une plateforme.
Le problème n’était pas l’existence de ces plateformes. Elles ont apporté simplicité, sécurité, distribution et confort. Le problème a commencé lorsque cette simplicité s’est transformée en dépendance structurelle, au point qu’une organisation pouvait difficilement changer d’environnement sans perdre une partie de ses données, de ses usages ou de son réseau.
Le Web3 s’est précisément construit en réaction à cette concentration, avec la promesse de redonner davantage de contrôle aux utilisateurs grâce à des architectures décentralisées, à de nouveaux modèles d’identité et à la réduction de certains intermédiaires. Là encore, la proposition contenait des idées intéressantes, mais elle s’est heurtée à une réalité classique : une architecture décentralisée n’est pas nécessairement simple. Wallets, clés privées, réseaux multiples, bridges, tokens, frais de transaction et mécanismes techniques difficiles à comprendre ont parfois ajouté tellement de complexité que l’utilisateur devait presque devenir administrateur de sa propre infrastructure avant même d’accéder au service recherché. La volonté de supprimer les intermédiaires avait parfois recréé une nouvelle couche d’intermédiaires.
L’IA générative arrive aujourd’hui dans ce paysage et rejoue une partie de la même partition.
Dépendance technologique : des citadelles aux bunkers internes
L’écosystème actuel est traversé par deux mouvements qui paraissent contradictoires mais se renforcent mutuellement. D’un côté, les capacités les plus coûteuses se concentrent autour d’acteurs capables de financer les modèles, les infrastructures de calcul, les données, la distribution et les interfaces. De l’autre, les organisations cherchent à préserver leur autonomie en assemblant leurs propres briques, leurs propres agents et leurs propres couches d’orchestration.
Nous construisons donc simultanément de grandes citadelles technologiques et une multitude de petits bunkers internes.
Cette réaction est parfaitement compréhensible. Une entreprise ne veut pas dépendre entièrement d’un seul fournisseur. Elle souhaite protéger ses données, conserver ses processus, contrôler ses accès et garder la possibilité de changer de technologie. Mais l’empilement n’est pas une stratégie d’indépendance en soi. Une architecture composée de quinze dépendances mal documentées peut être aussi fragile qu’un environnement complètement intégré chez un fournisseur unique.
Le sujet n’est donc pas de compter les briques, mais de savoir si elles sont remplaçables. Une dépendance n’est pas nécessairement mauvaise lorsqu’elle est visible, comprise, contractualisée, mesurée et réversible. C’est précisément le raisonnement développé dans le dossier consacré aux dépendances technologiques : la question importante n’est pas de supprimer toute dépendance, ce qui serait irréaliste, mais de savoir ce qui se passe lorsqu’elle devient critique.
Cette distinction devient essentielle à l’heure où les entreprises sont tentées de choisir en permanence "le meilleur modèle". La question reste utile, mais elle devient moins structurante à mesure que les classements évoluent, que certaines capacités convergent et que les différences d’un mois peuvent disparaître le mois suivant. Chercher sans cesse le moteur le plus performant revient alors à comparer les voitures sans se demander qui possède la route, qui contrôle les péages et si l’on pourra encore circuler lorsque le fournisseur changera les règles.
Pour une organisation, la valeur stratégique se déplace progressivement vers la portabilité des données, la capacité à remplacer une brique sans reconstruire l’ensemble, la maîtrise des workflows et surtout la conservation de la connaissance qui alimente tous ces systèmes. Autrement dit, le véritable avantage pourrait résider moins dans le modèle choisi que dans l’architecture construite autour de lui.
Knowledge Management : la mémoire devient un actif stratégique
Une organisation peut disposer du modèle le plus performant du marché et continuer à perdre chaque semaine une partie de son savoir dans ses emails, ses messageries, ses fichiers locaux, ses réunions et la mémoire de quelques collaborateurs. Ajouter une IA au-dessus de cette fragmentation ne crée pas automatiquement de la connaissance ; cela peut simplement accélérer la circulation d’informations déjà incomplètes, mal structurées ou difficiles à vérifier.
Un agent peut synthétiser un dossier incomplet. Une IA peut produire une réponse parfaitement formulée à partir d’une documentation obsolète. Une automatisation peut reproduire très efficacement une mauvaise procédure. Un résumé peut être excellent tout en effaçant le désaccord, le contexte ou la raison qui avait conduit à une décision. L’IA amplifie ce qu’on lui donne, mais elle ne transforme pas spontanément un système documentaire fragmenté en mémoire organisationnelle.
C’est ici que le Knowledge Management redevient central. Il distingue classiquement le savoir explicite, documentable et transmissible, du savoir tacite, lié à l’expérience, au contexte, aux habitudes de travail et aux arbitrages humains. Les modèles savent de mieux en mieux exploiter une masse considérable de connaissances explicites, mais ils ne capturent pas magiquement ce qui n’a jamais été formalisé. Pour cela, il faut encore des processus de transmission, des retours d’expérience, des décisions documentées, des responsabilités identifiables et une culture dans laquelle on conserve non seulement ce qui a été décidé, mais aussi pourquoi cela l’a été.
Dès lors, les questions stratégiques changent de nature. Il ne suffit plus de demander quelles données alimentent un modèle. Il faut savoir quelles informations font réellement autorité, qui valide les sorties générées, comment l’historique d’une décision est conservé, comment une source corrigée vient modifier la mémoire commune et ce qu’il reste lorsque l’organisation décide de changer de fournisseur.
Cette réflexion rejoint directement le sujet du lock-in cognitif et du prix de la pensée. Lorsque les connaissances, les habitudes de travail, les prompts, les historiques, les synthèses et les décisions finissent par vivre dans un même environnement propriétaire, le coût de sortie n’est plus seulement technique. Il devient organisationnel, parce qu’il touche à la manière même dont l’entreprise se souvient, travaille et décide.
MCP, A2A et DNS-AID : les ponts de l’interopérabilité IA
L’écosystème n’est toutefois pas condamné à cette fragmentation. Depuis 2024, plusieurs initiatives cherchent à créer des couches communes capables de relier les modèles, les outils et les agents.
Anthropic a lancé en novembre 2024 le Model Context Protocol, MCP, avec l’ambition de standardiser la manière dont les applications d’IA accèdent aux outils et aux sources de données. En décembre 2025, MCP a rejoint l’Agentic AI Foundation, créée sous l’égide de la Linux Foundation avec des contributions fondatrices d’Anthropic, Block et OpenAI. En août 2026, l’AAIF annonçait compter 247 organisations membres, signe que l’interopérabilité n’est plus seulement un sujet expérimental mais devient progressivement un enjeu industriel.
Google a de son côté lancé Agent2Agent, A2A, en avril 2025 pour permettre à des agents développés par différents fournisseurs ou avec différents frameworks de communiquer. Le protocole s’appuie sur des technologies Web existantes, notamment HTTP, SSE et JSON-RPC, ce qui est intéressant car il ne cherche pas à reconstruire Internet pour permettre aux agents de coopérer.
D’autres initiatives travaillent désormais sur un problème encore plus fondamental : comment découvrir une capacité ou un agent dans un environnement distribué. DNS-AID, annoncé par la Linux Foundation en mai 2026, propose d’utiliser l’infrastructure DNS pour publier, découvrir et vérifier des agents et des serveurs MCP sans dépendre d’un registre central. Quelques semaines plus tard, Google présentait Agentic Resource Discovery, une spécification ouverte destinée à publier, rechercher et vérifier des outils, des compétences et des agents distribués sur le Web.
Ces initiatives montrent que l’écosystème a identifié son propre problème de fragmentation. Elles ne garantissent cependant pas que l’avenir sera réellement ouvert. L’histoire du Web rappelle qu’un protocole ouvert ne suffit pas à empêcher la concentration économique. HTTP n’a pas empêché l’apparition de plateformes gigantesques et Kubernetes, malgré son rôle majeur dans la standardisation de l’orchestration cloud, n’a pas rendu tous les fournisseurs interchangeables.
La même prudence s’impose donc aujourd’hui. MCP, A2A, DNS-AID ou leurs successeurs ne régleront pas mécaniquement la question du verrouillage. Le véritable test sera beaucoup plus concret : pourra-t-on changer de modèle sans reconstruire son architecture, exporter réellement sa mémoire et son historique, remplacer un orchestrateur, faire collaborer des agents provenant de fournisseurs différents et conserver des permissions compréhensibles et auditables ?
La question centrale pourrait finalement ne pas être celle du modèle, mais celle de la mémoire. Qui conserve l’historique, les règles, le contexte, les identités et les décisions nécessaires au fonctionnement de ces systèmes ? Sur ce point, la réflexion rejoint celle menée autour de la semi-souveraineté et du contrôle réel : la maîtrise ne se proclame pas, elle se mesure couche par couche.
IA intégrée ou architecture interchangeable : deux stratégies
Face à cette incertitude, deux grandes approches apparaissent. La première consiste à privilégier l’intégration : confier modèle, identité, mémoire, stockage, agents et orchestration au même environnement afin de bénéficier d’une expérience homogène et d’un déploiement plus rapide. Le gain à court terme est évident, car l’entreprise réduit les frictions techniques, limite les développements spécifiques et profite d’une cohérence fonctionnelle difficile à reproduire en interne.
Cette simplicité crée néanmoins une dette de sortie. Si les tarifs augmentent, si les conditions contractuelles évoluent, si une fonction disparaît, si les contraintes de confidentialité deviennent incompatibles avec le fournisseur ou si une meilleure technologie apparaît ailleurs, la migration peut s’avérer beaucoup plus coûteuse qu’elle ne l’aurait été au départ.
L’autre approche consiste à construire une architecture plus interchangeable, avec des formats documentés, des interfaces standardisées, des données séparées des modèles, une mémoire exportable, des connecteurs remplaçables et une gouvernance explicite des accès. Cette voie demande davantage de compétences, de documentation et d’efforts initiaux, sans pour autant supprimer toutes les dépendances. Elle vise simplement à les rendre visibles et arbitrables.
Dans la pratique, la bonne stratégie se situe probablement rarement dans un extrême. Tout internaliser serait aussi irréaliste que tout déléguer. L’enjeu consiste plutôt à distinguer ce qui peut raisonnablement être confié à un fournisseur de ce qui doit rester sous contrôle de l’organisation : sa mémoire, ses données critiques, ses règles de décision, ses preuves et sa capacité à sortir d’un environnement sans repartir de zéro.
Vers des modèles IA interchangeables ?
Nous imaginons volontiers l’avenir de l’IA comme une succession de modèles toujours plus puissants, capables de produire davantage, de raisonner plus longtemps et d’agir avec toujours plus d’autonomie. Pourtant, la prochaine rupture décisive pourrait être beaucoup plus banale. Elle pourrait survenir le jour où nous cesserons de nous demander quelle IA utilise une application, exactement comme nous ne nous demandons presque jamais quelle implémentation de TCP transporte un message ou quel logiciel de serveur permet à deux systèmes de messagerie indépendants de communiquer.
À ce moment-là, un modèle pourrait devenir une composante interchangeable parmi d’autres. Une organisation pourrait choisir un moteur pour une tâche, un autre pour une donnée sensible, un troisième pour des raisons de coût ou de latence, sans reconstruire l’ensemble de son architecture ni perdre sa mémoire. Nous passerions alors progressivement d’une économie des assistants à une infrastructure de capacités, où la valeur se déplacerait du modèle vers la qualité de l’orchestration, de la donnée et de la connaissance.
Mais le scénario inverse reste tout aussi plausible. Quelques acteurs pourraient contrôler simultanément les modèles dominants, l’identité, la mémoire, les interfaces et les principaux outils d’orchestration. Les protocoles seraient ouverts, les spécifications seraient publiques et l’interopérabilité existerait techniquement, tandis que l’essentiel de la valeur économique resterait concentré dans quelques écosystèmes parfaitement intégrés.
Nous aurions alors inventé une technologie extraordinaire pour reproduire une histoire que le numérique connaît déjà très bien : quelques grandes forteresses, une multitude de petits territoires qui cherchent à conserver leur autonomie et des ponts dont tout le monde parle sans toujours savoir qui en contrôle les accès.
Ma lecture
Le point central n’est pas de choisir entre l’open source et le propriétaire, entre le local et le cloud ou entre un fournisseur et un autre. Ce serait retomber exactement dans la logique binaire que l’article cherche à dépasser. Une dépendance peut être parfaitement rationnelle lorsqu’elle est identifiée, contractualisée, mesurée et réversible ; inversement, une solution ouverte peut devenir une dépendance critique si personne dans l’organisation ne sait réellement la maintenir.
La question la plus importante consiste donc à préserver la capacité de choix. Au lieu de demander uniquement quelle IA adopter, les organisations devraient se demander quelle partie de leur connaissance, de leurs processus et de leur capacité de décision elles veulent encore maîtriser lorsque cette IA aura changé, lorsqu’un fournisseur aura disparu ou lorsqu’un nouvel outil aura remplacé celui qui semblait incontournable quelques mois auparavant.
Le Knowledge Management retrouve alors un rôle très ancien, presque banal, mais devenu beaucoup plus stratégique : permettre à une organisation de savoir ce qu’elle sait, pourquoi elle le sait, où cette connaissance se trouve et comment elle peut continuer à l’utiliser lorsque les outils changent.
La prochaine bataille de l’intelligence artificielle ne portera probablement pas seulement sur la puissance des modèles. Elle portera sur les ponts que nous construirons entre eux, sur la possibilité de les traverser dans les deux sens et, surtout, sur la capacité des organisations à ne pas perdre leur mémoire au passage.
Sources et références
- CERN, "The birth of the Web"
- CERN, "Licensing the Web"
- Anthropic, "Introducing the Model Context Protocol", 25 novembre 2024
- Linux Foundation, création de l’Agentic AI Foundation, 9 décembre 2025
- Linux Foundation, AAIF atteint 247 organisations membres, 13 août 2026
- Google Developers Blog, lancement du protocole Agent2Agent, 9 avril 2025
- Linux Foundation, lancement de DNS-AID, 27 mai 2026
- Google Developers Blog, Agentic Resource Discovery, 17 juin 2026



