


Le problème s’est déplacé
Le 11 septembre, l’analyse consacrée à PRISM 153 partait d’une question simple : le meilleur modèle est-il forcément celui qui doit répondre ? PRISM 153 propose d’ajouter une étape de légitimité avant l’inférence, afin de vérifier le domaine, les contraintes, les données concernées et la possibilité éventuelle de refuser ou d’escalader.
Le lendemain, Michel Vandenberghe a poussé la réflexion plus loin dans son article "PRISM 153 : Du routage au droit de répondre". Sa question déplace encore le centre de gravité : si une couche logicielle décide quel modèle a le droit de répondre, qui contrôle cette couche elle-même ?
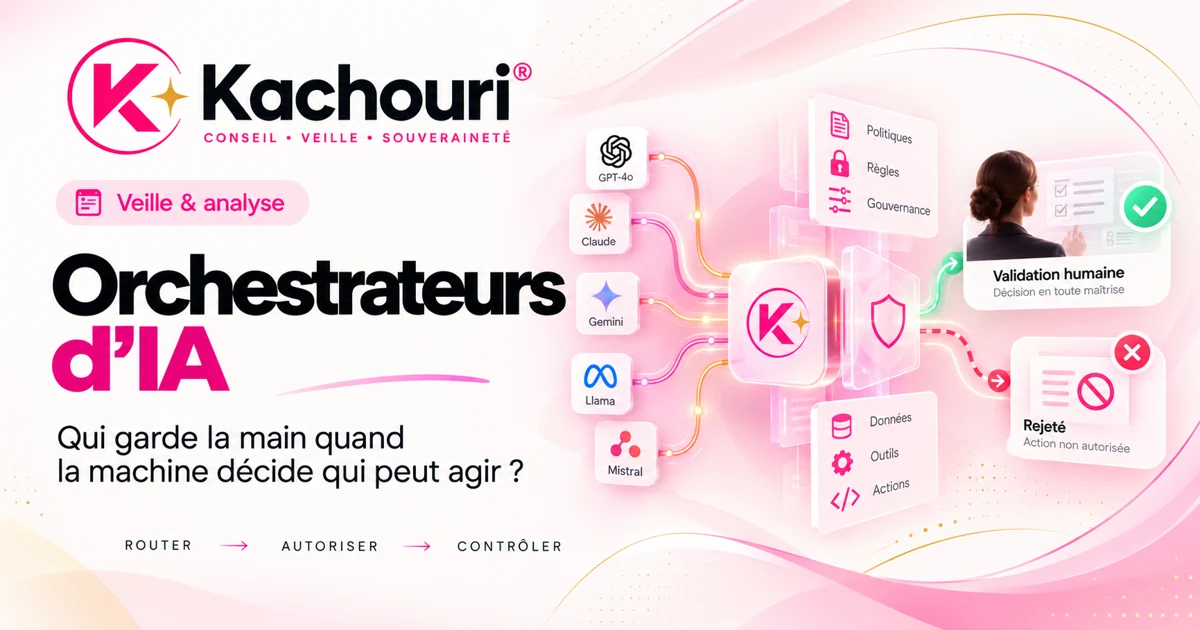
Ce déplacement est important. Tant qu’un routeur se contente d’envoyer une requête vers un modèle plus rapide ou moins cher, son erreur reste essentiellement une erreur d’optimisation. Mais un orchestrateur moderne peut faire davantage : sélectionner un corpus RAG, transmettre des données à un service distant, appeler un outil, modifier une base, déclencher un workflow ou interrompre une opération. À ce niveau, il ne distribue plus seulement du calcul. Il distribue des capacités d’action.
La question n’est donc plus uniquement de savoir si le modèle est fiable. Elle devient : qui définit les règles, qui autorise l’action, qui peut interrompre l’exécution et qui assume la décision lorsque le système se trompe ?
Router n’est pas gouverner
Le vocabulaire de l’IA mélange facilement des briques qui ne remplissent pas le même rôle. Cette confusion devient problématique lorsqu’elle masque la frontière entre une recommandation probabiliste et une autorisation réelle.
Un routeur de modèles choisit une ressource. RouteLLM, par exemple, travaille sur le compromis entre performance et coût en apprenant à diriger certaines requêtes vers un modèle plus puissant et d’autres vers un modèle moins coûteux. C’est une optimisation utile, mais RouteLLM ne prétend pas décider qu’un utilisateur a le droit d’accéder à un dossier ou qu’un agent peut déclencher un paiement.
Un routeur sémantique ajoute une analyse de la demande. vLLM Semantic Router combine plusieurs signaux pour orienter la requête vers un modèle adapté. PRISM 153 se greffe précisément à cette problématique en ajoutant la notion de légitimité. La proposition documentée par vLLM Semantic Router distingue qualification, classification et exécution. Elle reste cependant une proposition de recherche et d’architecture, pas une garantie universelle de sécurité.
Un moteur de politiques répond à une autre question : cette action respecte-t-elle les règles définies par l’organisation ? Open Policy Agent illustre cette séparation en évaluant des politiques déclaratives indépendamment de l’application qui demande la décision.
Enfin, l’autorisation détermine qui peut faire quoi sur quelle ressource. La documentation récente d’OpenFGA sur les agents insiste justement sur ce point : un agent peut disposer de sa propre identité, recevoir une délégation limitée et révocable, et ne pas hériter automatiquement de tous les droits de l’utilisateur pour lequel il agit.
Ces briques peuvent être assemblées, mais elles ne devraient pas être confondues. Le modèle peut proposer une action ; il ne devrait pas, à lui seul, décider qu’il est autorisé à l’exécuter.
L’humain dans la boucle n’est pas un bouton rouge
C’est ici que la première version de cette analyse allait trop vite. Elle évoquait la validation humaine comme une possibilité de fallback, alors que le human-in-the-loop mérite une place beaucoup plus structurante.
Mettre un humain dans la boucle ne consiste pas à installer quelqu’un devant un tableau de bord pour surveiller chaque requête. Ce serait coûteux, lent et souvent inutile. Le NIST rappelle d’ailleurs que les configurations humain-IA peuvent aller d’un fonctionnement entièrement automatisé à une décision entièrement humaine, et que tous les systèmes ne nécessitent pas le même niveau de supervision. En revanche, son AI Risk Management Framework demande que les rôles et responsabilités humaines dans la décision et la supervision soient clairement définis.
Le règlement européen sur l’IA va dans le même sens pour les systèmes à haut risque. L’article 14 de l’AI Act impose un contrôle humain effectif et proportionné au risque, au niveau d’autonomie et au contexte d’utilisation. Il précise notamment que la personne chargée de ce contrôle doit pouvoir comprendre les capacités et limites du système, interpréter ses sorties, rester attentive au biais d’automatisation et, lorsque cela est approprié, intervenir ou arrêter le système.
La nuance est essentielle : l’humain n’a pas besoin d’être partout, mais il doit pouvoir reprendre la main là où une décision produit une conséquence importante ou difficilement réversible.
Techniquement, ce modèle existe déjà dans les frameworks d’agents. LangGraph documente par exemple des interruptions human-in-the-loop capables de suspendre l’exécution avant un appel sensible, de conserver l’état du workflow, puis de laisser une personne approuver, modifier ou rejeter l’action avant sa reprise. Un agent peut donc préparer une opération sans disposer du dernier mot.
Cette mécanique paraît simple, mais elle change le rôle de l’orchestrateur. Celui-ci ne doit plus seulement savoir "quoi faire ensuite". Il doit aussi savoir quand il n’a plus l’autorité pour continuer seul.
Trois niveaux plutôt qu’une supervision permanente
Une gouvernance utile peut être beaucoup plus simple qu’un humain validant chaque étape.
Pour les opérations faibles en risque et facilement réversibles, l’orchestrateur peut agir automatiquement dans un périmètre défini. Pour les situations ambiguës, une confiance trop faible, une donnée plus sensible ou une règle contradictoire peuvent déclencher une revue humaine. Enfin, certaines actions devraient exiger une autorisation explicite avant exécution : supprimer des données, publier à l’extérieur, engager une dépense, modifier un registre métier critique ou transmettre une information sensible hors du périmètre prévu.
L’intérêt n’est pas de ralentir l’IA. Il est de placer le contrôle humain au bon endroit dans la chaîne de causalité.
Cela suppose aussi que la personne appelée à valider dispose de vraies informations. Un bouton "approuver" sans contexte ne constitue pas un contrôle. Il faut pouvoir voir l’action envisagée, les ressources concernées, le motif de l’escalade, les principales règles appliquées et, lorsque c’est pertinent, les conséquences attendues. Sinon, l’humain risque simplement d’entériner mécaniquement la proposition de la machine, phénomène que l’AI Act désigne explicitement comme un risque de biais d’automatisation.
L’humain dans la boucle ne vaut donc que s’il dispose de trois choses : l’information, l’autorité et le temps de décider.
Séparer proposition, permission et action
Cette distinction permet de dessiner une architecture plus lisible sans chercher à inventer un "super-orchestrateur".
Le modèle ou l’agent peut proposer : utiliser un outil, interroger un document, changer de modèle ou lancer une action. Un moteur de politique ou d’autorisation vérifie ensuite si cette proposition est recevable dans le contexte. L’orchestrateur coordonne le workflow et, lorsqu’un seuil est franchi, suspend l’exécution pour demander une décision humaine. Ce n’est qu’après ces contrôles que l’action est exécutée.
Cette séparation limite un problème classique : laisser le même composant produire une décision, interpréter la règle qui l’encadre et s’accorder lui-même le droit d’agir. L’Answer Engineering traite une question complémentaire sur la sortie ; ici, le problème se situe un étage plus haut, dans l’autorité qui décide si cette sortie peut déclencher une action.
Les travaux récents d’OWASP vont clairement dans cette direction. L’Agent Control Standard publié en septembre 2026 part du constat que les agents utilisés en entreprise doivent être inspectables, traçables et contrôlables au runtime, notamment sur ce qu’ils peuvent accéder et exécuter. Il ne fournit pas à lui seul une architecture universelle, mais il confirme le déplacement du problème : lorsqu’une IA devient agentique, la sécurité ne peut plus se limiter au contenu de sa réponse.
Cette logique vaut également pour les outils exposés via MCP. OpenFGA documente désormais le contrôle d’accès aux serveurs MCP, avec des permissions au niveau des outils et des ressources. L’enjeu n’est plus seulement "l’agent connaît-il cet outil ?", mais "est-il autorisé à l’utiliser ici, au nom de cette personne, sur cette ressource ?".
Une nouvelle dépendance peut se cacher dans l’orchestrateur
Le sujet rejoint une question déjà abordée dans le dossier Kachouri sur les dépendances technologiques. Multiplier les modèles ne garantit pas la liberté de choix si toute la logique de décision finit enfermée dans une plateforme d’orchestration impossible à remplacer.
Une organisation peut utiliser un modèle local, plusieurs API cloud et différents moteurs spécialisés tout en restant dépendante d’une seule couche qui contient ses règles, ses workflows, ses permissions et son historique de décisions. La dépendance n’a pas disparu. Elle a simplement changé d’étage.
La réversibilité devrait donc concerner aussi le plan de contrôle. Une règle importante devrait pouvoir être lue et testée sans dépendre d’une interface propriétaire. Les permissions devraient être exportables et versionnées. Les changements devraient pouvoir être tracés. Les journaux nécessaires à l’audit devraient rester exploitables en dehors du fournisseur qui les produit. Et surtout, le remplacement d’un routeur ou d’un modèle ne devrait pas imposer de reconstruire la gouvernance depuis zéro.
Cette lecture rejoint un principe déjà rencontré dans l’analyse de KENTA : la valeur d’un système ne tient pas uniquement à sa capacité d’agir, mais aussi à sa capacité à borner l’action, refuser et laisser une trace intelligible.
Auditer la décision avant d’auditer la réponse
Lorsqu’une IA produit une mauvaise réponse, on examine naturellement le modèle. Dans une architecture orchestrée, ce n’est plus suffisant. Il faut aussi pouvoir demander pourquoi cette requête a été envoyée à ce modèle, pourquoi telle donnée lui a été accessible, quelle politique était active, pourquoi un outil a été autorisé et pourquoi aucune intervention humaine n’a été demandée.
L’audit se déplace donc vers la chaîne de décision.
Cela ne signifie pas qu’il faut tout journaliser. Recopier systématiquement prompts, documents internes et réponses dans des logs techniques peut lui-même créer un problème de confidentialité. L’objectif est plutôt de conserver les éléments nécessaires pour reconstituer l’arbitrage : versions de politiques, identités, décisions d’autorisation, modèle retenu, motifs d’exclusion, point d’escalade et validation humaine lorsqu’elle existe.
La question devient très concrète en cas d’incident : le modèle a-t-il mal répondu, ou l’orchestrateur n’aurait-il jamais dû lui donner la possibilité de répondre ou d’agir ?
Cette différence est fondamentale pour comprendre la responsabilité.
La sophistication n’est pas une garantie
Il serait tentant d’en conclure qu’il faut ajouter toujours plus de classifieurs, de routeurs, de politiques et de vérificateurs. Ce serait manquer une partie du problème.
Chaque couche supplémentaire introduit sa propre latence, sa configuration, ses erreurs possibles et sa surface d’attaque. Ajouter un modèle probabiliste pour contrôler un autre modèle probabiliste ne transforme pas mécaniquement l’ensemble en système déterministe. Dans certains cas, une architecture beaucoup plus sobre sera préférable : un modèle spécialisé connu, des permissions strictes, quelques règles explicites et une validation humaine avant les opérations sensibles.
Le niveau de sophistication doit suivre le risque réel de l’action, pas la mode architecturale du moment. C’est également la logique défendue dans IA responsable : encadrer ne suffit pas à garder la maîtrise : inventaire des usages, permissions, supervision et réversibilité doivent rester proportionnés au contexte réel.
C’est probablement le meilleur contrepoids à l’idée d’un orchestrateur central capable de tout arbitrer. Un bon système n’est pas celui qui prend toutes les décisions. C’est celui qui sait lesquelles il peut prendre automatiquement, lesquelles doivent être bloquées et lesquelles doivent revenir à une personne.
Ce que l’on peut réellement conclure
PRISM 153 apporte une question utile : avant de répondre, un modèle est-il légitime dans ce contexte ? Le prolongement proposé par Michel Vandenberghe ouvre une seconde question : qui gouverne la couche qui attribue cette légitimité ?
Les sources actuelles permettent d’aller un cran plus loin. Les moteurs de politique comme OPA, les modèles d’autorisation fine comme OpenFGA, les mécanismes d’interruption de LangGraph, les travaux du NIST et les exigences de contrôle humain de l’AI Act montrent qu’une partie importante de cette gouvernance existe déjà sous forme de composants, de pratiques et de cadres distincts.
En revanche, il serait excessif de prétendre qu’une architecture universelle de "gouvernance de l’orchestrateur" est aujourd’hui stabilisée. Les usages, les niveaux de risque et les capacités d’action sont trop différents pour imposer le même mécanisme partout.
La conclusion est plus sobre : plus une IA dispose de capacité d’action, moins il est acceptable que son autorité repose uniquement sur sa propre interprétation du contexte.
Ma lecture
Le sujet m’intéresse moins comme une nouvelle catégorie de produit que comme une règle d’architecture. Cette lecture alimente également Complexiance, projet en cours orienté vers la complexité de l’intelligence artificielle et des sciences, précisément parce que l’orchestration relie toujours plusieurs couches de décisions, de contraintes et de rétroactions. IA et pensée complexe pousse d’ailleurs à regarder cette gouvernance comme un ensemble de rétroactions entre règles, agents, humains et organisation, plutôt que comme une simple succession de composants indépendants. Si un orchestrateur peut décider quel modèle répond, quelles données circulent et quels outils sont appelés, il faut lui appliquer les mêmes questions que celles que nous posons aux modèles : qui le contrôle, qui peut le remplacer, que garde-t-il en mémoire, que peut-on auditer et que se passe-t-il lorsqu’il ne sait pas ?
J’ajouterais désormais une question qui manquait à la première version : à quel moment l’humain reprend-il réellement la main ?
Pas symboliquement. Pas après l’incident. Pas uniquement parce qu’une interface comporte un bouton "stop". L’humain doit être placé dans la boucle lorsque son arbitrage est nécessaire, avec suffisamment de contexte pour comprendre la décision et suffisamment d’autorité pour la modifier, la refuser ou arrêter l’exécution.
C’est probablement là que se situe la limite la plus saine de l’orchestration : une machine peut trier, qualifier, recommander, vérifier des règles et préparer une action. Mais lorsqu’elle commence à distribuer elle-même des droits et des conséquences, le véritable test de gouvernance est de savoir si quelqu’un peut encore lui dire non, comprendre pourquoi, et reprendre la main sans reconstruire tout le système.
Sources et références
Liens internes Kachouri.com
- PRISM 153 : le protocole qui veut décider quelle IA est légitime pour répondre
- Answer Engineering : après le prompt, définir ce qu’une réponse doit respecter
- IA responsable : encadrer ne suffit pas à garder la maîtrise
- IA et pensée complexe : ce qu’Edgar Morin change à notre manière de la gouverner
- Dépendances technologiques : cartographier, arbitrer, sortir
- KENTA : l’organisme numérique d’un homme qui ne savait pas coder
- Souveraineté numérique ou semi-souveraineté : mesurer le contrôle réel
Sources externes
- Michel Vandenberghe, "PRISM 153 : Du routage au droit de répondre", 12 septembre 2026
- vLLM Semantic Router, PRISM : 153-key Legitimacy Layer for Model Selection
- Isaac Ong et al., RouteLLM: Learning to Route LLMs with Preference Data
- NIST, AI Risk Management Framework 1.0 et Human-AI Interaction
- Règlement (UE) 2024/1689 sur l’intelligence artificielle, article 14
- OWASP GenAI Security Project, Agent Control Standard, publié le 1er septembre 2026
- Open Policy Agent, documentation officielle
- OpenFGA, Authorization for Agents
- OpenFGA, Authorization for MCP Servers
- LangChain / LangGraph, Human-in-the-loop
- Complexiance, projet en cours sur la complexité de l’intelligence artificielle et les sciences, consulté le 30 septembre 2026



