


Le problème à comprendre
Le routage des modèles d’intelligence artificielle a longtemps été présenté comme un problème d’optimisation : choisir le bon modèle au bon moment, en arbitrant entre qualité, coût et latence. Cette logique reste valable, mais elle devient insuffisante dès qu’une entreprise commence à exploiter simultanément plusieurs modèles spécialisés, un ou plusieurs LLM généralistes, des bases documentaires, des RAG, des ressources locales et des services cloud. À ce stade, la question n’est plus seulement "quel modèle répond le mieux ?", mais "quel modèle a réellement le droit, la compétence et le contexte nécessaires pour répondre à cette demande ?".
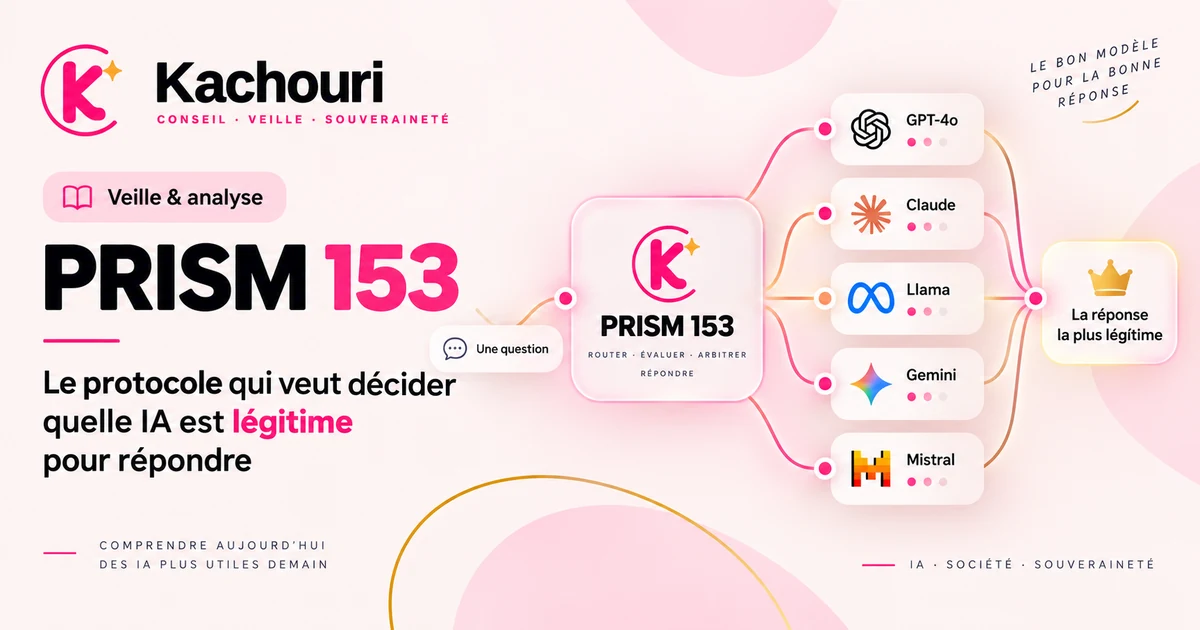
C’est précisément ce que PRISM 153, pour Protocol for Routed Intelligent Specialized Models, cherche à formaliser : un protocole de routage et de légitimité placé avant l’appel aux SLM ou LLM afin de déterminer si un modèle est compétent, autorisé et suffisamment fiable pour traiter une requête. Le travail de Mossaab Hassana Souaissa part d’un principe simple, résumé dans le papier publié en février 2026 : "Knowledge must be routed before it is resolved". La réponse ne devrait donc intervenir qu’après une qualification explicite de la demande et du modèle appelé.
Cette problématique est née du terrain. Dans ses échanges, Mossaab Souaissa explique avoir rencontré cette limite lors de l’implantation de l’IA dans un environnement industriel connecté notamment à un MES. Un même modèle pouvait être pertinent sur une demande et beaucoup moins fiable sur une autre, selon le métier, le contexte ou la nature des données. La difficulté ne consistait donc plus à "avoir une IA", mais à savoir comment décider laquelle peut intervenir, dans quelles conditions, avec quelles données, à quel coût et avec quelle possibilité de retour en arrière.
Ce déplacement rejoint directement une question que Kachouri traite régulièrement autour des dépendances technologiques : une architecture peut être performante tout en devenant fragile si personne ne sait réellement quelles briques sont indispensables, substituables, auditables ou remplaçables.
Ce que les faits montrent
PRISM 153 repose sur une idée architecturale claire : insérer une couche de décision entre la requête et l’exécution. Dans le papier initial, cette architecture s’appuie sur un VSLM chargé de classifier l’intention sans produire de réponse métier, un registre dynamique des compétences, le 153-key qui encadre la qualification et l’exécution, puis une boucle de retour destinée à faire évoluer les scores observés.
Le 153-key est le cœur du protocole. Son nom ne désigne pas seulement un identifiant technique : selon Mossaab Souaissa, il doit être compris comme une clé de cohérence et de contrainte, destinée à rendre le comportement du modèle moins verbeux, moins dispersé et davantage raisonné dans son périmètre. L’idée n’est pas de produire plus de texte, mais de mieux encadrer la décision qui précède la réponse et d’obliger le modèle à reconnaître ses limites plutôt qu’à improviser.
Dans la documentation vLLM Semantic Router, la proposition apparaît sous le titre "PRISM - 153-key Legitimacy Layer for vLLM-SR Model Selection". Elle est explicitement présentée comme complémentaire du routeur existant : vLLM Semantic Router cherche à déterminer quel modèle est le mieux adapté à une requête, tandis que PRISM cherche à vérifier si le modèle sélectionné est légitime pour répondre. La proposition documente trois clés, qualification, classification et exécution, ainsi qu’un 153-Registry destiné à conserver les compétences et limites déclarées ou observées des modèles. La documentation prévoit également plusieurs modes d’intégration, dont un mode hybride entourant le routeur existant. Cette proposition a bien été ajoutée à la documentation et référencée dans les releases du projet, mais l’issue de recherche associée précise toujours qu’il ne faut pas confondre ces travaux avec une garantie de sécurité ou de qualité en production.
Le routage lui-même n’est donc pas nouveau. RouteLLM travaille déjà sur la sélection dynamique entre modèles selon le compromis coût/performance. Les architectures Mixture of Experts activent des experts spécialisés. SelectiveNet et la prédiction sélective ont depuis longtemps formalisé l’idée qu’un système peut s’abstenir. AgentDNS explore la découverte et l’adressage de services et d’agents. PRISM 153 se distingue surtout par la manière dont il assemble ces briques autour d’une question de légitimité préalable, de refus explicite et de contrainte opératoire.
Ce que le terrain montre
Le projet a cependant évolué depuis le papier initial. Dans nos derniers échanges, Mossaab Souaissa indique que PRISM 153 est aujourd’hui achevé à environ 95 %. Ce chiffre correspond à son estimation de l’avancement du projet, et non à une mesure indépendante de maturité. Il précise que les principaux mécanismes fonctionnent déjà : qualification des requêtes, routage multi-modèles, prise en charge de modèles locaux et cloud, politiques, permissions, traçabilité, suivi des tokens et des coûts, refus explicables et mécanismes d’escalade.
Il décrit notamment une chaîne possible du type modèle local → modèle spécialisé → modèle généraliste plus puissant → validation humaine. Cette logique évite d’envoyer systématiquement chaque requête vers la ressource la plus coûteuse ou la plus généraliste. Elle permet aussi de garder la possibilité de refuser si aucun modèle ne satisfait les conditions de compétence, de sécurité ou de contexte.
Mossaab Souaissa indique également travailler sur des mécanismes complémentaires, notamment du buffering, afin de mieux gérer les étapes intermédiaires, les délais et les changements de modèle sans perdre la cohérence d’exécution. À ce stade, ces éléments correspondent au retour de l’auteur et ne disposent pas encore, dans les sources publiques que nous avons vérifiées, d’une documentation détaillée permettant d’en mesurer précisément le comportement ou l’impact.
Ce cas d’usage résume bien le changement de perspective : l’utilisateur ne choisit plus directement l’IA, l’organisation définit les règles selon lesquelles un modèle peut être utilisé.
Le mécanisme derrière le problème
Le mécanisme devient intéressant lorsqu’on cesse de considérer le routeur comme un simple aiguillage technique. PRISM 153 ajoute une couche de gouvernance qui doit répondre à plusieurs questions avant l’exécution : quel domaine est concerné, quel modèle est enregistré comme compétent, quelles données sont en jeu, quelles politiques d’accès s’appliquent, quelle confiance est acceptable, quelles ressources sont autorisées et que faut-il faire en cas de refus ?
Cette logique s’inscrit dans une approche d’architecture maîtrisable : il ne suffit pas qu’un système fonctionne, il faut aussi pouvoir comprendre pourquoi il prend une décision, quelles briques il mobilise et dans quelles conditions il peut être repris ou modifié.
L’un des aspects les plus structurants est la place accordée au refus. Un modèle peut être capable de répondre techniquement tout en n’étant pas autorisé à traiter la donnée, en n’ayant pas le bon périmètre ou en n’offrant pas un niveau de confiance acceptable. Dans ce cas, la "bonne réponse" du système n’est pas nécessairement du texte supplémentaire. Cela peut être une demande de clarification, un autre routage, une validation humaine ou un refus.
Cette approche rejoint directement une logique d’IA responsable : les rôles, les données, les limites et la capacité de reprise en main doivent être compréhensibles par ceux qui assument les conséquences de la décision.
Ce que cela change
L’intérêt de PRISM 153 apparaît surtout dans les environnements où le nombre de modèles augmente. Tant qu’une organisation n’utilise qu’un seul fournisseur ou un seul LLM généraliste, la complexité reste limitée. Dès qu’elle ajoute des modèles locaux, des modèles métier, plusieurs clouds et plusieurs bases de connaissances, la dépendance se déplace vers la couche d’orchestration. Sans règles explicites, l’entreprise peut remplacer une dépendance visible par une dépendance plus difficile à comprendre : celle du routeur, de ses politiques et de ses décisions automatiques.
Le projet de Mossaab Souaissa cherche précisément à éviter cette opacité en rendant le choix du modèle traçable et explicable. Sa lecture de la dépendance est d’ailleurs plus intéressante que l’opposition classique entre "local" et "cloud". Un système peut parfaitement utiliser plusieurs fournisseurs ou infrastructures si l’organisation sait quelles données peuvent circuler, dans quelles conditions, pour quelles raisons et avec quelle possibilité de sortie.
Cela ouvre également un pont intéressant avec le Knowledge Management. Dans l’article consacré à OAM, après le RAG, une mémoire qui relie et évolue, la question porte sur la mémoire, le contexte, la provenance, les relations et l’évolution de la connaissance. PRISM 153 intervient à une autre couche : il ne cherche pas à organiser cette mémoire, mais à déterminer quel modèle peut la mobiliser dans un contexte donné.
Il faut donc éviter de confondre les deux. OAM traite la connaissance et sa continuité, PRISM 153 traite la décision d’accès et d’exécution. Leur articulation permet néanmoins de dessiner une chaîne plus large : mémoire et connaissance → qualification de la demande → règles et contraintes → routage → exécution → preuve → retour d’expérience.
Cette lecture peut aussi prolonger les réflexions autour de Divinexa, de la mémoire et du Knowledge Management : plus un système accumule de contexte, plus il devient important de savoir qui peut utiliser quelle information, dans quelles limites et sous quelle responsabilité.
Ce que l’on ne peut pas conclure
PRISM 153 ne peut pas encore être présenté comme une architecture démontrée à grande échelle. Le papier initial rapporte plus de cent tests manuels sur onze modèles et annonce 100 % de cohérence sur les scénarios de qualification, de refus et d’acceptation testés. Ces chiffres doivent rester dans leur contexte : l’auteur reconnaît un échantillon limité, l’absence de métriques standards telles que Precision, Recall ou F1, l’absence de tests adversariaux et une automatisation encore incomplète à l’époque du papier.
Les sources publiques de vLLM Semantic Router vont dans le même sens. L’issue de recherche consacrée aux signaux de légitimité inspirés de PRISM précise que les résultats du papier sont des éléments fournis par l’auteur et qu’ils n’établissent pas, à eux seuls, la sécurité, l’autorisation, l’expertise ou la qualité en production. Elle souligne également qu’une auto-évaluation produite par un modèle reste une sortie non fiable tant qu’elle n’est pas encadrée par des politiques opérateur, des preuves versionnées et des mécanismes de calibration.
Autrement dit, l’idée est cohérente, l’implémentation semble avoir fortement progressé et le projet est présenté comme proche de son achèvement, mais la maturité scientifique et opérationnelle doit encore être établie par des tests reproductibles et indépendants.
Ma lecture
PRISM 153 devient intéressant précisément à l’endroit où beaucoup de projets IA restent encore flous : la décision qui précède l’appel au modèle. Le protocole ne prétend pas seulement optimiser un choix technique. Il cherche à encadrer la capacité d’un modèle à intervenir, à réduire les réponses hors périmètre, à éviter les appels inutiles et à rendre les dépendances plus visibles.
La 153-key, comprise comme clé de cohérence et de contrainte, apporte à ce titre une intuition simple mais pertinente : un bon système n’est pas nécessairement celui qui parle le plus, mais celui qui sait rester dans son domaine, raisonner dans un cadre défini et refuser lorsque les conditions ne sont pas réunies.
Le principal risque reste celui de la surcouche. Une architecture déjà équipée de politiques solides, d’un classifieur, d’un registre de modèles et de mécanismes de fallback peut reproduire une partie des fonctions décrites par PRISM 153. La valeur du protocole devra donc être démontrée sur ce qu’il apporte réellement en précision, en réduction des erreurs de routage, en maîtrise des coûts, en stabilité et en auditabilité.
À ce stade, PRISM 153 n’est ni une rupture complète ni un simple doublon. C’est une tentative cohérente de transformer le routage en décision gouvernée. Et dans un contexte où les entreprises passent progressivement d’un modèle unique à un portefeuille de modèles, de mémoires et de services, cette question devient difficile à éviter : avant de demander à une IA de répondre, avons-nous défini les conditions dans lesquelles elle peut réellement le faire ?
Sources et références
- Mossaab Hassana Souaissa, profil LinkedIn
- Mossaab Hassana Souaissa, PRISM: A DNS-Inspired Semantic Routing Architecture for Specialized Large Language Models, Zenodo, 23 février 2026
- PRISM-153, dépôt GitHub de Mossaab Souaissa
- PRISM — 153-key Legitimacy Layer for vLLM-SR Model Selection, vLLM Semantic Router
- vLLM Semantic Router, issue #1422 sur les signaux de légitimité inspirés de PRISM
- vLLM, issue #35804, PRISM 153-key Legitimacy Verification Layer
- Isaac Ong et al., RouteLLM: Learning to Route LLMs with Preference Data, 2024
- Yonatan Geifman, Ran El-Yaniv, SelectiveNet: A Deep Neural Network with an Integrated Reject Option, ICML 2019
- Enfang Cui et al., AgentDNS: A Root Domain Naming System for LLM Agents, 2025



