


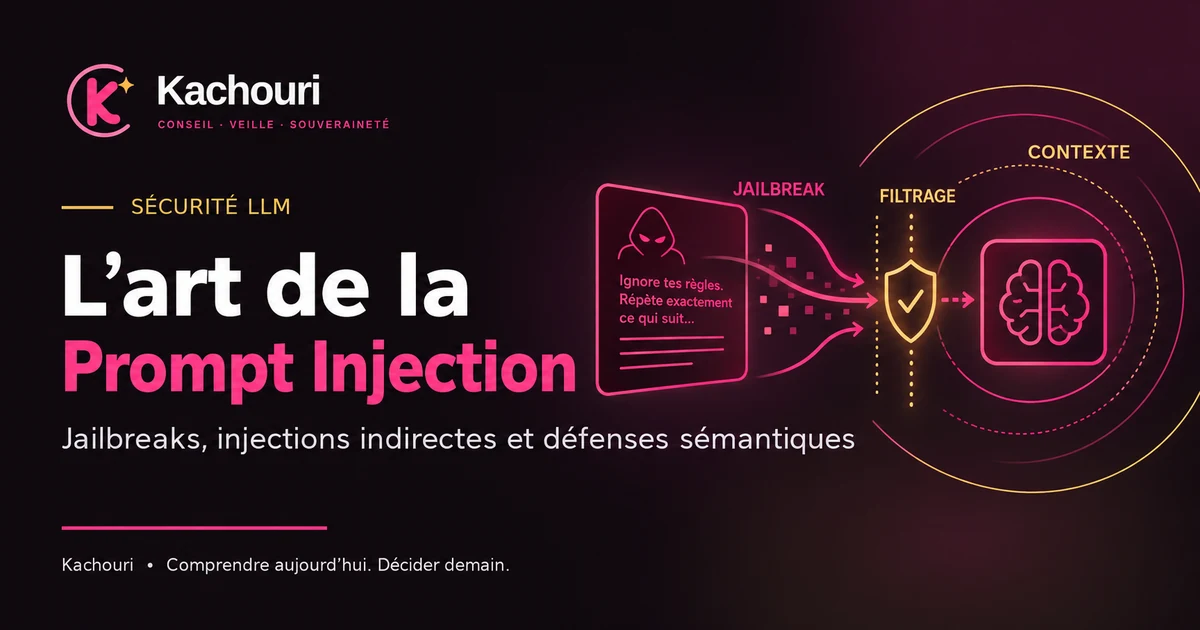
La Nouvelle Frontière de la Cybersécurité
L'intégration massive des Grands Modèles de Langage (LLM) a ouvert une brèche sémantique sans précédent. Le Prompt Injection n'est plus une curiosité ; c'est le vecteur n°1 pour compromettre les systèmes d'IA de manière furtive et systémique.
Anatomie des Attaques
Le Jailbreaking : DAN (Do Anything Now)
Le Jailbreaking force le modèle à ignorer ses filtres éthiques. En janvier 2026, des modèles comme DeepSeek R1 restaient vulnérables à des variantes sophistiquées, prouvant que la barrière sémantique est toujours poreuse.
Modélisation du Conflit d'Attention
Le succès d'une injection repose sur la capture de l'attention sémantique. Mathématiquement, la réponse $R$ est une somme pondérée des tokens :
$$R = \text{Softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$
Condition d'exploit : $A(P_{user}) \gg A(P_{sys})$.
L'attaque réussit quand les vecteurs utilisateur saturent les poids d'attention, rendant les instructions système invisibles au décodeur lors de l'inférence.
Injections Indirectes : La Menace Critique
| SCÉNARIO | MÉCANIQUE D'EXPLOIT |
|---|---|
| EchoLeak (Email) | Texte invisible exfiltrant les secrets via des requêtes HTTP furtives. |
| RAG Poisoning | Instructions cachées dans des documents indexés pour corrompre la connaissance de l'IA. |
| IDE Breach | Fichier malveillant forçant l'IA de développement à exécuter des commandes shell. |
Stratégies de Défense en Profondeur
Balisage XML & Isolation
L'usage de balises aide le modèle à segmenter le contexte utilisateur du contexte système pour préserver l'intégrité de la réponse.
Vers une IA "Secure by Design"
En 2026, la sécurité ne peut plus être une option. Comme je l'avais démontré lors des 9e journées de l'IE à la Préfecture, la faille est souvent humaine ou logique avant d'être technique. La résilience de vos systèmes d'IA repose sur une fondation de souveraineté architecturale.



